
阅读要点
先读这里,快速了解全文在讲什么
核心结论
想给应用加上自然点的中英文朗读,又不希望被某家云服务限制住,F5-TTS 是个能在本地直接跑起来的选择。它面向愿意自己配置环境的开发者和内容创作者:提供一段几秒长的参考音频,再输入文本,就能用相近的音色把文字念出来。核心看点它用 流匹配(Flow Matching) 来做语音合成,而不是传统扩散模型那种多步采样思路,因此生成过程更轻;项目支持多语言与中英混排,做字幕配音或播客试听都比较省心;仓库里还给了 Gradio 界面和命令行入口,…
你可以了解到
阅读后可获得与「F5-TTS:几秒语音样本,让文字用同一音色读出来」相关的实用信息与站内延伸资源;最后更新 2026年11月9日。
延伸阅读
想给应用加上自然点的中英文朗读,又不希望被某家云服务限制住,F5-TTS 是个能在本地直接跑起来的选择。它面向愿意自己配置环境的开发者和内容创作者:提供一段几秒长的参考音频,再输入文本,就能用相近的音色把文字念出来。
核心看点
它用 流匹配(Flow Matching) 来做语音合成,而不是传统扩散模型那种多步采样思路,因此生成过程更轻;项目支持多语言与中英混排,做字幕配音或播客试听都比较省心;仓库里还给了 Gradio 界面和命令行入口,想先听效果再改代码都可以。文档里也有训练和微调的说明,换数据集或调整音色时,不必从零摸索。
上手提示
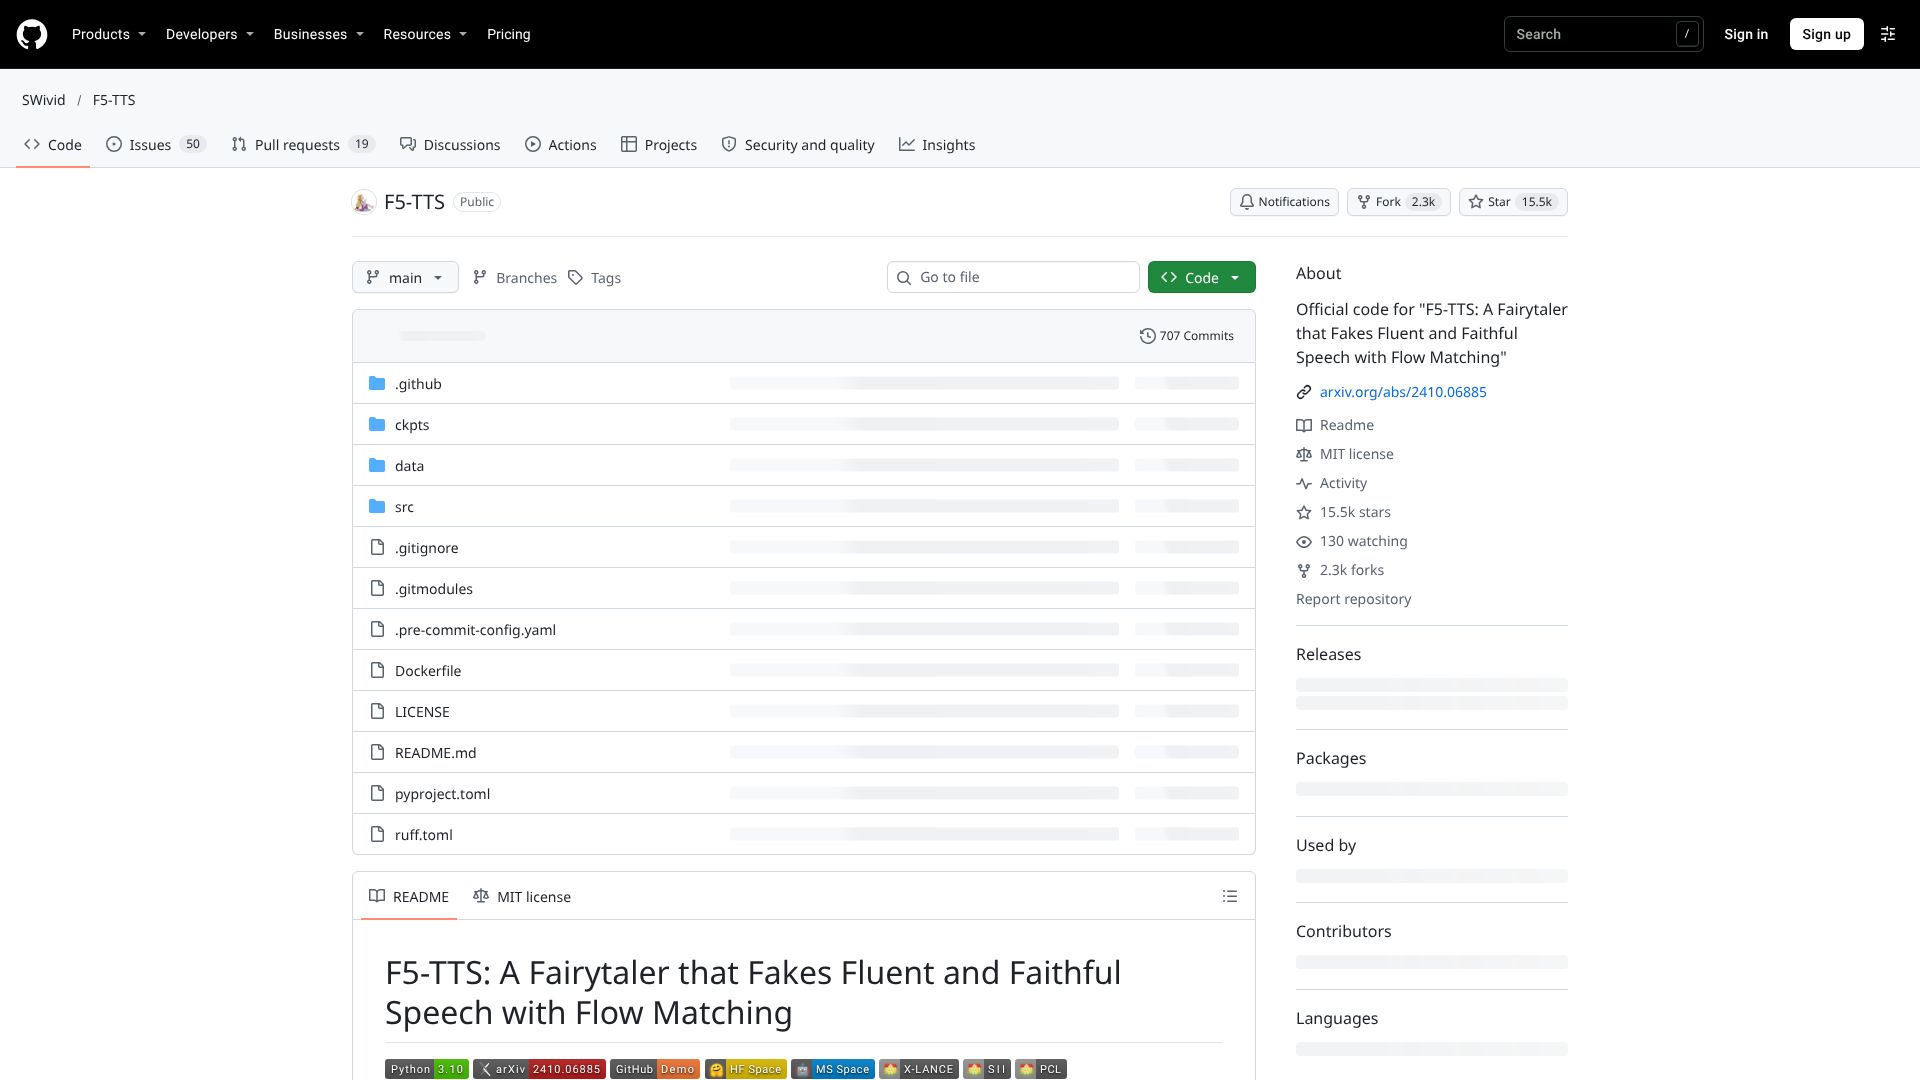
需要 Python 环境,推理建议配一块 GPU;CPU 也能跑,但会慢不少。首次运行时,要从 Hugging Face 下载模型权重,请留意权重页面上的许可说明。代码仓库采用 MIT 许可证;二次修改或商用前,请以仓库内的 LICENSE 和权重条款为准。
如果想听合成样例、看最近的更新记录和社区讨论,可以直接从 README 里的演示音频入手,再逛一圈 F5-TTS 开源仓库。


